前几天,我第一次看到 TypeSafe AI 这个名字。
当时其实没多想,只是顺手问了一句:
TypeSafe AI 是什么东西?
我原本以为,它大概率又是一家做模型 API、Agent 工具或者 AI 基础设施的公司。
结果一路看下来,发现他们做的东西还挺特别。
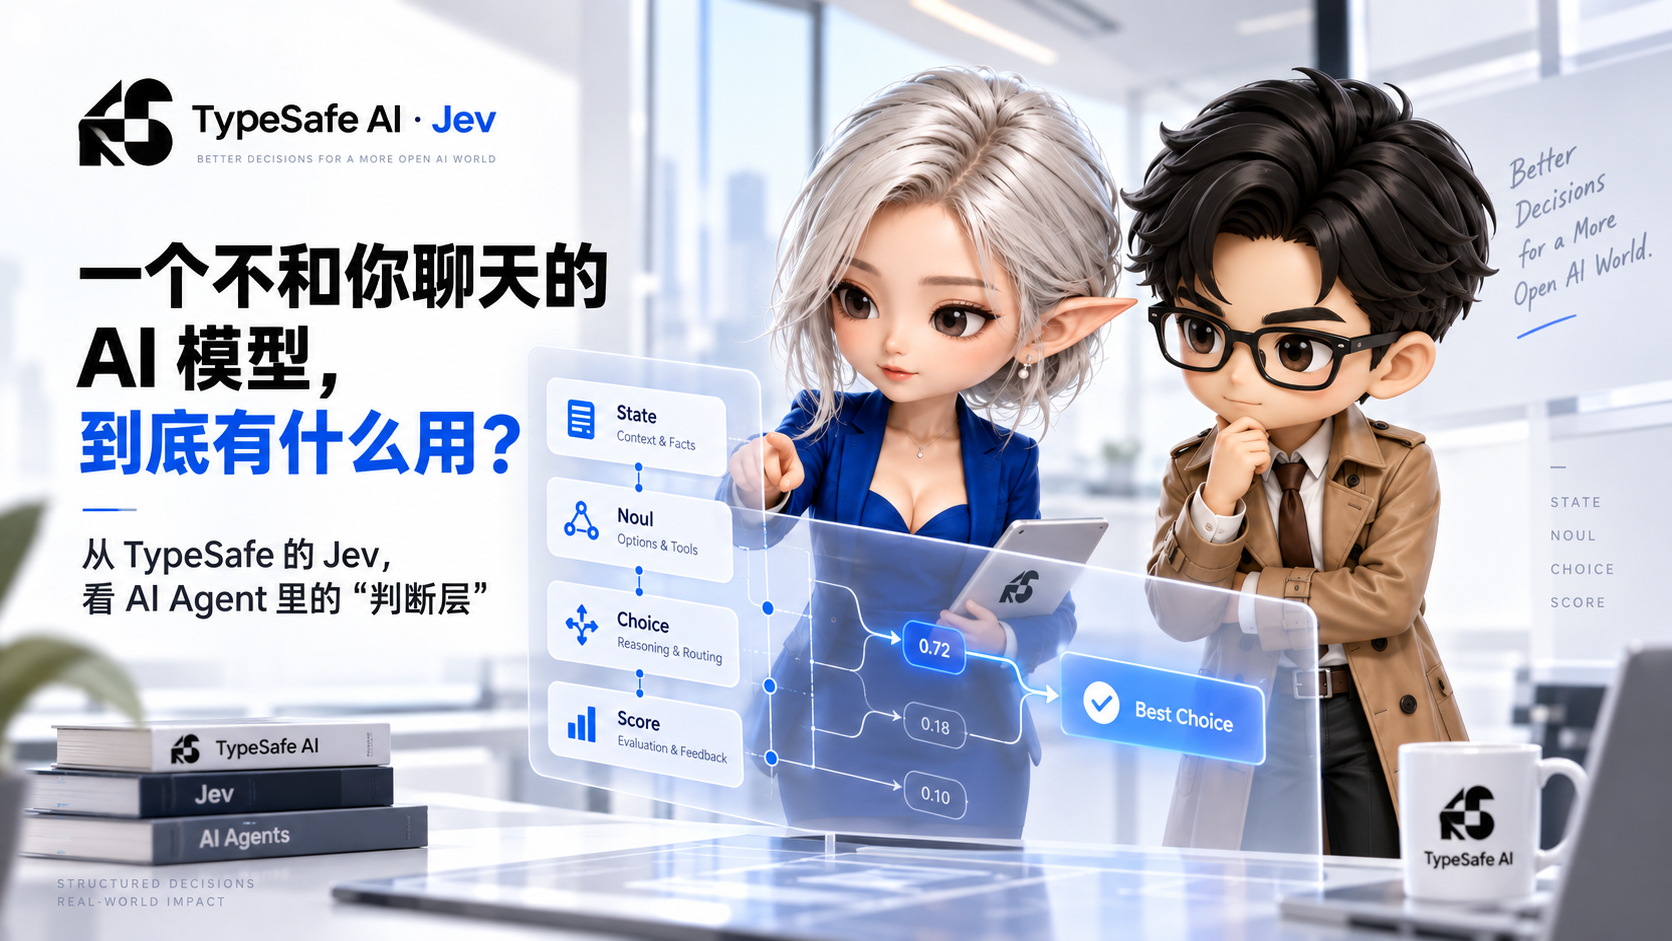
TypeSafe 现在公开的第一个模型叫 Jev。
官方把它称为:
System One Model
但真正让我停下来看的,是他们给 Jev 的另一个定义:
Smart if-statements
智能 if 语句。
我第一反应其实很简单:
这不就是个分类器吗?
现在 AI 圈每天都在讲更强推理、更大上下文、多模态、Coding Agent、Computer Use。
结果 TypeSafe 跑出来说:我们做了一个模型,主要负责判断。
它不会陪你聊天,也不负责写文章、写代码、生成答案。
听上去甚至有点“退步”。
但继续往下看之后,我发现这件事比想象中有意思。
先想一个最普通的 if
普通程序里经常会写:
if balance < 0:
    send_warning()
这种判断计算机最擅长,因为条件非常明确。
余额小于 0,就是 True。
问题出在另外一类判断。
比如:
if customer_is_angry:
    escalate_to_human()
“客户生气了”到底怎么定义?
再比如:
if agent_action_is_risky:
    ask_for_confirmation()
什么叫“有风险”?
或者:
if document_is_relevant:
    add_to_context()
什么叫“真的和当前问题有关”?
这些判断人很容易理解,但很难写成一套完整的传统规则。
现在最常见的做法,是直接扔给 GPT、Claude 或 Gemini。
让大模型读完上下文,然后返回一个 JSON:
{
  "risk": "high",
  "requires_confirmation": true
}
当然能用。
但仔细想一下,其实有点奇怪。
我们调用了一个可以写程序、做研究、写长文、分析复杂问题的大模型,只是为了回答:
这个操作危险不危险?
Jev 想解决的就是这一类问题。
Jev 本质上是在做“语义判断”
它不生成一大段文字。
你给它一个当前状态,然后告诉它你需要判断什么。
它返回结构化结果和概率。
目前主要有三种形式。
Noul
可以理解成概率版 Yes / No。
例如:
这个操作是否可能删除数据?它可能返回:
0.94意思是:Yes 的概率大约 94%。
Choice
从几个明确选项里选一个。
例如:
这封客服邮件属于什么类型?

Billing
Technical Support
Sales
Account Management
Jev 会选择其中一个,同时给出各个选项的概率。
Score
按照你自己定义的等级评分。
例如:
客户现在有多不满?

0 正常
1 略有不满
2 明显不满
3 很生气
4 需要立即人工介入
它返回一个等级和对应概率。
看到这里其实就很好理解了。
Jev 没有想当一个“小号 Claude”。
它更像是给程序增加了一种过去很难写出来的条件:
if semantic_judgement():
    ...
真正让我开始认真看它,是 Agent
我们后来聊了很多可能的应用。
客服分类、发票处理、安全告警、RAG 检索、工具路由……
但对我来说,最有意思的还是 AI Agent。
假设我对一个 Agent 说:
把这个 Docker 项目清理一下,然后重新启动。
Agent 计划执行:
docker compose down -v这里的 -v 可能会删除 volume。
如果是现在常见的 Agent 架构,很可能又调用一次大模型:
判断一下这个操作有没有风险,要不要向用户确认。
Jev 的思路会更细。
把问题拆成几个非常明确的小判断:
这个操作是否可能删除持久化数据?
是否会修改系统状态?
用户有没有明确授权这个操作?
是否应该在执行前再次确认?
假设 Jev 返回:
可能删除数据:0.97
修改系统状态:0.99
需要用户确认:0.96
接下来怎么办,还是代码决定。
if requires_confirmation > 0.9:
    ask_user()
我很喜欢这种关系。
AI 提供判断,代码执行规则,人保留最终权限。
这比把整套逻辑都塞进一个 Prompt 里,让大模型自己决定下一步干什么,更容易控制。
Agent 里其实到处都是这种“小判断”
现在很多 Agent 架构有一个问题:
几乎什么都让大模型判断。
例如:
- 该调用哪个工具?
- 搜索出来的资料有没有用?
- 这个操作风险高不高?
- 用户有没有真的授权?
- 这个任务要不要升级给更强的模型?
- 当前结果需不需要重新执行?
- Agent 有没有偏离用户原始目标?
每一个问题都可以调用 GPT。
但这些事情真的都需要一个大型 reasoning model 吗?
未必。
如果 Jev 这种模型真的可靠,Agent 的结构以后可能会变成:
用户
 ↓
快速判断
 ↓
普通代码
 ↓
需要时调用 GPT / Claude
 ↓
工具执行
 ↓
再做一次快速判断
 ↓
完成
大模型主要负责真正需要推理、规划和生成的部分。
其他那些高频、小粒度、语义型的判断,交给专门模型。
这个思路我觉得是成立的。
还有一个特点:一次可以判断很多事情
Jev 的 Playground 里有两个很明显的区域:
State和:
QuestionsState 就是当前上下文。
比如:
用户要求:
清理 Docker 项目并重新启动。

当前环境:
生产服务器。

准备执行:
docker compose down -v
然后你可以一次问:
是否可能删除数据?
是否涉及生产环境修改?
是否需要用户确认?
是否涉及敏感信息?
风险等级是多少?
这些问题可以并行处理。
这点对 Agent 很重要。
因为一次工具调用前面,往往同时有好几个检查项。
如果每个问题都单独调用一次传统 LLM,延迟和费用会不断累积。
Jev 的设计更适合这种:
同一个状态,同时判断很多件事。
然后我开始问一个更现实的问题
了解得越多,我反而越想知道:
这件事情 OpenAI 或 Anthropic 自己不能做吗?
这其实是我现在对 TypeSafe 最大的疑问。
因为 Noul、Choice、Score 这些概念本身并没有高到无法复制。
OpenAI、Anthropic、Google 都有训练模型的能力,也有巨大的开发者生态和推理基础设施。
如果以后大家都发现:“AI 软件确实需要一个专门做判断的小模型。”
那这些公司完全可以自己做。
所以我现在不太认为:
Jev 这个模型本身就是 TypeSafe 最重要的护城河。
真正可能形成壁垒的,是它周围那一整套东西。
- Calibration
- Decision Evaluation
- Threshold Management
- Agent Policy
- Model Routing
- Observability
- Production Feedback
- Domain-specific Decision Data
换句话说,如果 TypeSafe 最后只是提供一个又快又便宜的判断模型,那竞争压力会非常大。
但如果它能变成:
AI 软件里的 Decision Layer
那意义就不一样了。
TypeSafe 对 Jev 的缺点倒是说得很直接
这一点我觉得挺好。
他们没有把 Jev 描述成万能模型。
官方文档明确写了不少目前的弱点。
比如:
- 数学不行
- 精确数字计算不要依赖它
- 日期和时间比较也不适合交给它
- 复杂间接推理容易掉性能
- 上下文里无关信息太多,会影响判断
- 专业领域知识也不是它的强项
- 它本身也不会生成文本
官方给开发者的建议其实非常简单:
数学 → 代码算
日期 → 代码处理
需要写东西 → 用 LLM
需要复杂推理 → 用 reasoning model
需要快速语义判断 → 用 Jev
我觉得这个划分挺健康。
过去几年大家已经有点形成习惯:
有问题先扔给 LLM。
TypeSafe 反过来提醒你:
先想一下,这个任务到底需不需要 LLM。
我最关心的其实不是快,也不是便宜
TypeSafe 对 Jev 的两个卖点很直接:
快。
便宜。
他们给出的数字甚至非常夸张。
20 到 200 倍更快。
40 到 1000 倍更便宜。
这些东西其实都比较容易验证。
真正让我感兴趣的是另外一个词:
Calibration。
简单理解就是:Jev 给出的概率到底有没有意义。
比如:
0.9如果长期测试下来,模型在输出 0.9 的情况下,大约真的有 90% 是对的,那这个数字就非常有用了。
因为程序可以写:
> 0.95
直接自动处理

0.75 - 0.95
交给更强模型再看一遍

< 0.75
让人处理
AI 会犯错并不稀奇。
更麻烦的是:
它犯错之前,你通常不知道。
如果模型能够比较可靠地表达:“这件事我很确定。”或者“这件事我其实没什么把握。”
那 uncertainty 本身就变成了一种可以写进程序的信号。
这才是我真正想测试 Jev 的地方。
于是我干脆去申请了
聊到这个程度,再继续看别人的介绍已经没什么意思。
所以我直接申请了 TypeSafe 的测试资格。
申请里有个问题:
你想先拿 TypeSafe 做什么?
我写的是:
先把它放进一个 AI Agent 系统里,当 decision layer。
主要用来测试:
- 工具路由
- 权限判断
- 风险检查
- 什么时候该升级给更大的 reasoning model
因为我自己一直在做 ACKS Studio,也一直在思考 Agent 的系统设计。
我希望 Agent 更像一个真正的软件系统。
哪些地方能自动做。
哪些地方必须询问。
哪些动作危险。
哪些东西应该交给大模型。
这些都应该尽量看得见。
而不是把所有行为全部交给一个模型自由发挥。
申请里还问:
你做过最酷的东西是什么?
我写了 ACKS Studio。
然后是网站、X。
最后还有一道很随意的问题:
Got a favourite meme?
我填了:
This Is Fine。
做开发的人大概都知道为什么。
后来真的收到了邀请
通过申请以后,我进入了 TypeSafe 的 onboarding 页面。
一上来,他们就把 Jev 的定位写得很清楚:
结构化输出。
并行判断。
带概率的结果。
Calibration。
还有它不擅长的东西。
然后真正进入 Console 之前,还有一道小测试。
题目是:
Can you chat with Jev?
答案:
No。
这道题其实挺有意思。
过去几年,我们一直在研究:
怎么和 AI 聊天。
TypeSafe 第一个要你理解的反而是:
别把这个东西当聊天模型。
进入 Console 之后,我才真正理解他们想做什么
Jev 的 Playground 里没有一个大大的聊天框。
没有:
How can I help you today?
左边是 State。
下面是 Questions。
你要先告诉它:
现在发生了什么。
然后明确告诉它:
你希望它判断什么。
甚至官方刚开始给你的例子都很简单:
热狗算不算三明治?
天空是什么颜色?
猴子能不能创作艺术?
然后才开始进入比较真实的场景:
Résumé screening。
Support agent audit。
LLM guardrails。
这种交互方式其实很能说明 Jev 的定位。
它不是等着和你聊天的助手。
它更像一个准备塞进代码里的“判断模块”。
Prompt Engineering 之后,可能还有 Decision Engineering
我现在反而觉得,Jev 如果真的流行起来,开发者可能会多一种新的能力要求。
以前大家研究的是:
Prompt 怎么写。
以后可能还要研究:
问题应该怎么拆。
例如:
这个操作安全吗?其实就很含糊。
可以拆成:
是否可能永久删除数据?
是否修改生产环境?
是否会访问凭证?
用户是否明确授权?
是否应该要求确认?
然后让模型分别判断。
最后由代码组合。
这时候很多过去藏在 Prompt 里的逻辑,又重新回到了软件架构里。
对我来说,这反而是好事。
因为系统会更容易理解,也更容易测试。
普通用户可能永远不会直接用 Jev
但这类模型最终可能和普通人关系很大。
现在大家提到 AI,第一反应还是:
聊天。
生成。
写东西。
以后可能有大量 AI 根本不会出现在界面上。
比如:
邮箱自动判断哪些邮件真的重要。
银行判断一笔交易是不是异常。
客服系统判断哪些问题可以直接解决。
搜索工具判断哪些资料是真的相关。
Agent 判断一个动作有没有风险。
如果模型自己不确定,就先停下来问人。
这些事情发生的时候,用户可能根本不知道后面用了什么 AI。
AI 会慢慢从一个你主动打开的“功能”,变成软件系统的一部分。
我觉得这反而是更值得注意的方向。
对 Agent 来说,我现在更看重的是这套架构思想
我现在还不会说:
Jev 一定能成功。
TypeSafe 一定有很深的护城河。
或者它宣传的能力全部成立。
因为我才刚拿到测试资格。
真正重要的问题都还没测。
比如:
- 它的概率到底准不准
- 同一句话换个说法,结果会不会明显漂移
- 遇到专业领域,它会不会主动降低信心
- 模糊情况下,它会不会非常自信地判断错
这些才是关键。
但有一件事我现在越来越认同:
Agent 没必要把所有问题都交给最大的模型。
未来比较合理的结构,可能更像:
普通代码
↓
快速语义判断
↓
需要时才进入复杂推理
↓
执行工具
↓
结果检查
确定性的事情交给代码。
模糊判断交给 Jev 这一类模型。
真正复杂的问题,再交给 GPT、Claude 或 Gemini。
这样看起来反而重新回到了软件工程。
只是软件里多了一种新的基础能力:
判断。
接下来,我准备直接测
第一项测试我已经想好了。
做一个:
Agent Operation Risk Gate
我会准备一批真实操作,比如:
git status
git reset --hard
docker compose restart
docker compose down -v
cat .env
rm -rf ./build
rm -rf ./data
然后让 Jev 判断:
有没有数据丢失风险?
是否会修改系统状态?
是否涉及敏感信息?
是否需要用户确认?
我会先自己标注答案。
然后拿 Jev 跑一遍。
再和 GPT 或 Claude 做对照。
我不会只看 Accuracy。
我更想看:
- False Negative
- Calibration
- 同义改写后的稳定性
- 模糊输入下的表现
- Latency
- Cost
最关键的一点是:
Jev 不确定的时候,到底是不是真的知道自己不确定。
如果这件事成立,我会明显提高对它的评价。
因为那时候它就不只是一个便宜、快速的分类器。
它可能真的可以成为 Agent 里一个新的基础组件。
几天前,TypeSafe AI 对我来说还只是一个名字。
后来我知道了 Jev。
接着开始研究它到底能干什么。
然后开始怀疑它的问题和护城河。
最后干脆申请测试资格。
现在已经进了 Console。
所以接下来没什么好猜的了。
直接测。
看看所谓的 Smart if-statements,到底只是一个好听的新概念,还是 AI Agent 真的缺了这么一层。
参考资料
- TypeSafe Documentation — Introduction
- TypeSafe Documentation — Primitives
- Introducing System One Models and Jev
- Jev 1.13 Model Jaggedness
- TypeSafe Evals
了解 ~/jintaoblog/朝夕见闻志⚡️ 的更多信息
订阅后即可通过电子邮件收到最新文章。